Як я побудував конвеєр субтитрів для 106 серій за допомогою Whisper, Groq і Python
Коротко
- Whisper створює відсутні вихідні субтитри перед перекладом. Спочатку я використовував власний сервер, а тепер – Whisper на Groq, який на моїй конфігурації працював швидше.
translate_subtitles.pyспочатку шукає українські субтитри на OpenSubtitles. Якщо версії відео збігаються за вмістом, скрипт може виправити постійне зміщення часу й рівномірне розходження таймінгу.TRANSLATOR_CHAINзадає порядок Google, MyMemory, LibreTranslate, Argos і Claude CLI, а також повторні спроби й збільшення тайм-аутів. До наступного кроку переходять лише репліки без прийнятного результату.- Кожен запуск пропускає наявні результати й записує перебіг роботи в журнали. Типовий поріг прийняття – 60 відсотків охоплення реплік, тому збережений файл усе ще може містити англомовні діалоги.
Завдання було ширшим за переклад
У мене було 106 серій The Fosters у форматі .mkv. Для деяких був англійський файл .srt, для інших не було субтитрів узагалі, а кілька мали українські субтитри з таймінгом під іншу версію відео. Я хотів отримати відтворюваний процес для всіх трьох випадків, який не змушував би починати вже виконану роботу заново.
Для цього потрібно було розділити два завдання, які легко змішати:
- Створити SRT мовою оригіналу з аудіо серії, якщо придатних вихідних субтитрів немає.
- Отримати SRT цільовою мовою: знайти готові субтитри, синхронізувати їх або перекласти.
translate_subtitles.py виконує друге завдання. Сам Whisper він не запускає. У повному процесі спочатку працює допоміжний скрипт транскрибування, а потім створений англійський SRT передається конвеєру перекладу.
Очевидного циклу було недостатньо:
for line in subtitles:
    translated = translator.translate(line)
Такий цикл нічого не говорить про те, як:
- створювати репліки з часовими мітками з аудіо, коли для серії немає SRT;
- знаходити готовий український файл до того, як витрачати ресурси на переклад;
- відхиляти файли з помилковою позначкою української мови;
- підлаштовувати таймінг субтитрів під іншу версію відео;
- переходити до іншого перекладача, коли результат порожній або не містить кирилиці;
- зберігати результати роботи між кількома запусками.
Першим відсутнім етапом було розпізнавання мовлення.
Етап 1: створити вихідний SRT з аудіо
У моєму першому варіанті для пакетної обробки whisper-asr-webservice працював на сервері. Клієнт підключається через SSH, рекурсивно знаходить відеофайли, пропускає ті, поруч із якими вже є SRT, і надсилає решту до ендпоінта /asr на сервері.
export WHISPER_ASR_HOST="server.example.net"
export WHISPER_ASR_USER="media"
export WHISPER_ASR_SSH_KEY="$HOME/.ssh/id_whisper"
export WHISPER_LANGUAGE="en"

./whisper_batch.sh "/srv/media/The Fosters"
За запити до власного сервера не потрібно було платити, але на моєму обладнанні він працював повільно, а транскрипти потребували більшої кількості виправлень, ніж мені хотілося. Я залишив цей скрипт як варіант для автономної роботи, але перестав використовувати його за замовчуванням.
Зараз я використовую transcribe-groq.py. Він витягує моноаудіо з частотою 16 кГц через FFmpeg, стискає його в Ogg Opus, ділить довгі записи на 25-хвилинні фрагменти, звертається до ендпоінта транскрибування Whisper від Groq, відновлює абсолютні часові мітки, перевіряє текст і таймінг сегментів та атомарно записує один SRT. Він зберігає повторювані репліки й фрази, які можна помилково прийняти за галюцинації; їх потрібно перевіряти вручну. Наявний результат захищено, якщо я не передам --force, і навіть тоді порожній або некоректний результат залишить попередній SRT недоторканим.
export GROQ_API_KEY="your-api-key"

python3 transcribe-groq.py \
  "The Fosters S01E01.mkv" \
  --language en \
  --prompt "Character names: Lena, Stef, Callie, Jude"
Промпт необов’язковий. Я використовую його лише для імен і термінів, які Whisper, імовірно, розпізнає неправильно. Опублікована версія не містить особистого промпту, локального шляху, адреси сервера, логіна чи API-ключа.
Обидва допоміжні скрипти доступні поруч з основним:
- Завантажити скрипт транскрибування через Groq
- Завантажити скрипт пакетного транскрибування через власний сервер Whisper
Жоден із цих варіантів не гарантує правильності вихідного транскрипту. Перед перекладом варто вибірково перевірити імена, підписи до музики, одночасні репліки й місця розрізання аудіо на фрагменти.
Groq отримує фрагменти аудіо. Google, MyMemory і Claude отримують текст субтитрів, коли до них доходить черга в ланцюжку; OpenSubtitles отримує метадані пошуку та дані автентифікації для власного API. Для приватних матеріалів обирайте сервіси, чиї правила роботи з даними відповідають вмісту, або використовуйте власний сервер транскрибування й автономний переклад.
Коли вихідний SRT уже є, решта процесу може ухвалювати одне рішення для кожної серії, а не для кожної репліки.
Конвеєр
Для кожної серії двоетапний процес виконує такі кроки:
- Пропустити серію, якщо результат
.uk.srtуже існує. - Створити англійський SRT з аудіо, якщо вихідних субтитрів немає.
- Знайти українські субтитри на OpenSubtitles.
- Відхилити варіанти, які не проходять базову перевірку мови й структури.
- Підібрати лінійне перетворення таймінгу за локальним англійським файлом.
- Якщо жоден варіант не підійшов, перекласти унікальні фрази субтитрів через ланцюжок резервних сервісів.
- Записати результат і оновити структурований журнал запуску та консольний журнал.
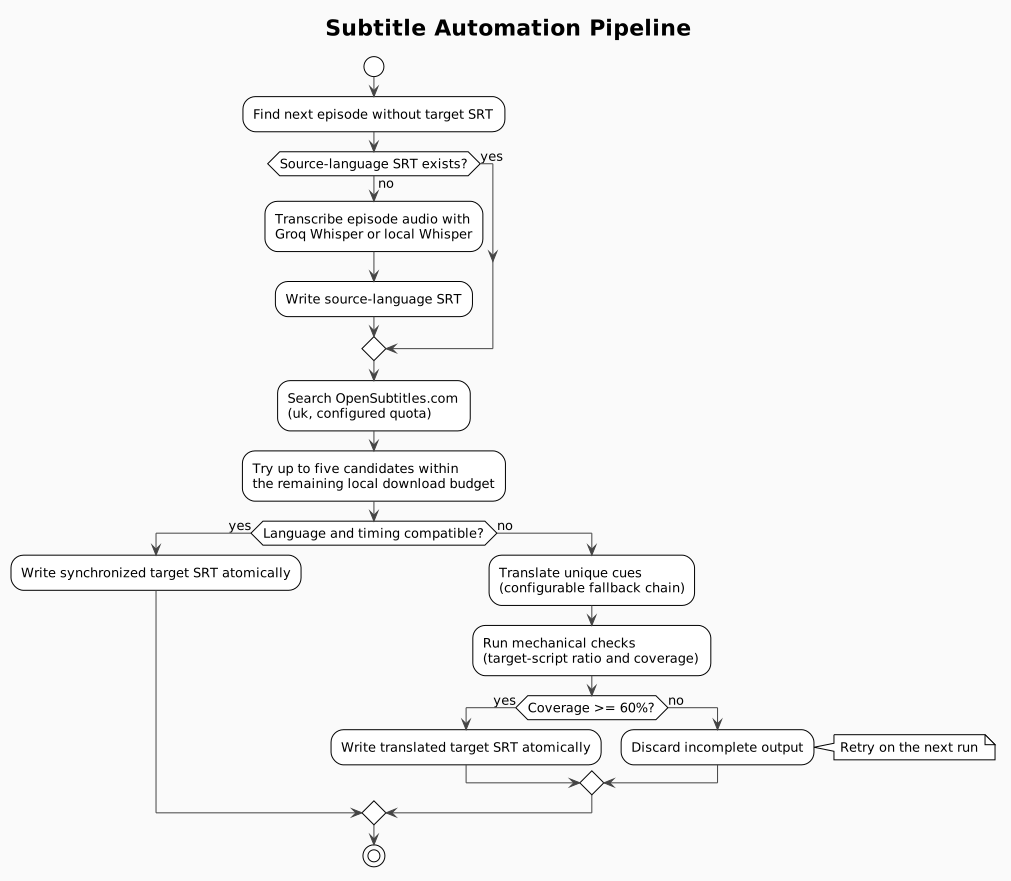
Якщо знаходиться придатний готовий файл субтитрів, робота завершується ще до виклику будь-якого перекладача.
Спочатку пошук, потім переклад
Скрипт звертається до OpenSubtitles API з назвою серіалу, номером сезону, номером серії, отриманими з імені файлу, і налаштованим кодом цільової мови. За вбудованих налаштувань TARGET_LANGUAGE_CODE має значення uk.
data = _os_get("/subtitles", {
    "query": title,
    "season_number": season,
    "episode_number": episode,
    "languages": TARGET_LANGUAGE_CODE,
})
Квоти OpenSubtitles залежать від облікового запису й споживача API, тому локальну межу можна налаштувати. У скрипті, доступному для завантаження, типовим значенням є 20. Це налаштування, а не гарантія: задайте для OPENSUBTITLES_DAILY_LIMIT ліміт, указаний для вашого облікового запису.
Облікові дані теж мають зберігатися поза файлом:
OPENSUBTITLES_API_KEY      = os.environ.get("OPENSUBTITLES_API_KEY", "")
OPENSUBTITLES_ACCESS_TOKEN = os.environ.get("OPENSUBTITLES_ACCESS_TOKEN", "")
OPENSUBTITLES_USERNAME     = os.environ.get("OPENSUBTITLES_USERNAME", "")
OPENSUBTITLES_PASSWORD     = os.environ.get("OPENSUBTITLES_PASSWORD", "")
OS_DAILY_LIMIT = int(os.environ.get("OPENSUBTITLES_DAILY_LIMIT", "20"))
Для пошуку скрипт надсилає API-ключ, а для завантаження вимагає автентифіковану сесію. Це правило самого скрипту: OpenSubtitles також описує обмежений доступ без автентифікації. Скрипт приймає OPENSUBTITLES_ACCESS_TOKEN безпосередньо або під час запуску отримує токен сесії за іменем користувача й паролем. У скрипті не передбачено запису облікових даних у журнал; перед поширенням журналів перевіряйте їх.
Результатам пошуку не можна довіряти лише тому, що в метаданих зазначено uk. Скрипт бере перші 50 реплік, перевіряє, чи текст переважно кириличний, і шукає характерні для української мови літери, зокрема і, ї, є та ґ. Суто російські літери, як-от ы, э і ъ, погіршують оцінку кандидата.
Тепер обмеження застосовується до фактичних спроб /download, а не лише до прийнятих субтитрів. Навіть відхилений варіант може витратити квоту API, тому кожна спроба завантаження зменшує залишок локального ліміту. Коли він сягає нуля, скрипт пропускає OpenSubtitles і переходить до ланцюжка перекладу.
Короткі фрагменти, імена, пісні й діалоги кількома мовами можуть обдурити цей фільтр. Він виконує одне корисне завдання: відхиляє багато явно неправильно позначених файлів до того, як вони потраплять у каталог результатів. Він не доводить, що решта тексту українською.
Коли варіант проходить цю перевірку, наступним можливим джерелом помилки стає таймінг.
Дві точки можуть виправити розходження таймінгу, але не відмінності монтажу
Таймінг субтитрів для різних релізів часто відрізняється на постійне зміщення від початку. Іноді він також поступово розходиться через іншу частоту кадрів відео. Лінійне перетворення враховує обидва ефекти:
new_time = scale * old_time + offsetСкрипт бере час початку першої та останньої репліки з локального англійського файлу й завантаженого українського файлу:
scale = (en_t1 - en_t0) / (uk_t1 - uk_t0)
offset = en_t0 - scale * uk_t0
Потім він відхиляє підозрілі збіги:
- кількість реплік може відрізнятися щонайбільше на 20 відсотків;
scaleмає залишатися в межах 10 відсотків від1.0;- час початку перших п’яти реплік після перетворення має відрізнятися від відповідних англійських не більш як на дві секунди.
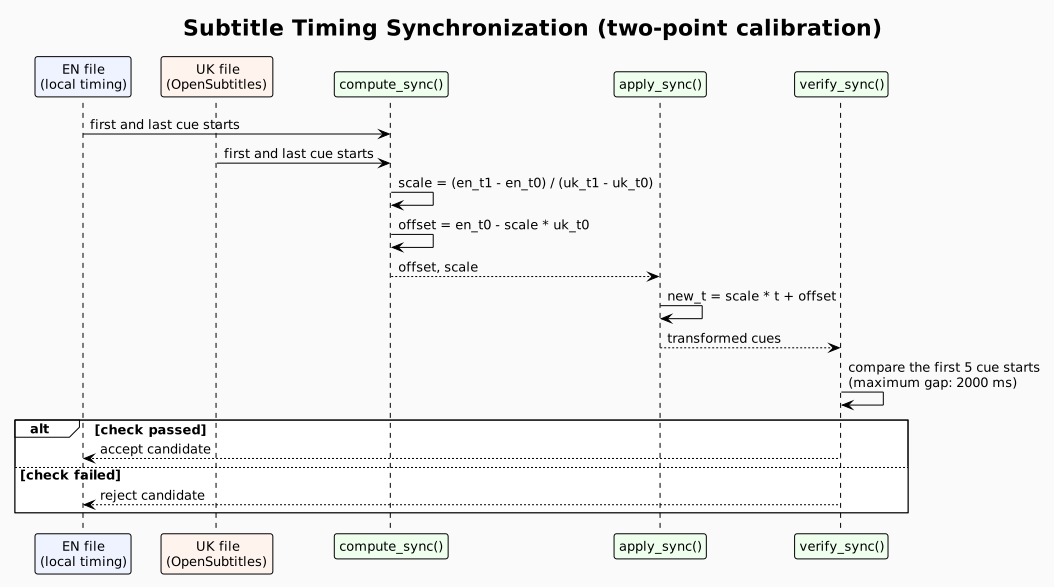
Це працює, коли перша й остання репліки відповідають тим самим моментам, а розбіжність приблизно лінійна. Метод не працює, якщо в одному релізі додано короткий переказ попередніх подій, прибрано підписи, інакше розділено діалог або вставлено додаткову сцену. Надійніший синхронізатор зіставляв би вміст реплік чи звукові орієнтири, замість того щоб припускати відповідність за індексом.
Коли сумісного українського файлу немає, конвеєр нарешті береться за переклад.
Налаштовуваний Chain of Responsibility
Ланцюжок налаштовується на початку скрипту:
TRANSLATOR_CHAIN = (
    "Google (2:30) -> MyMemory (1:10) -> "
    "LibreTranslate (1:20) -> Argos -> Claude"
)
Будь-який зареєстрований сервіс можна поставити на будь-яке місце в TRANSLATOR_CHAIN. Парсер пропускає недоступні сервіси й використовує перший із решти для основного пакета. Зв’язаний ланцюжок резервних сервісів дотримується того самого порядку.
«Доступний» тут навмисно означає перевірку локального налаштування, а не перевірку працездатності сервісу в реальному часі. Скрипт перевіряє наявність потрібного Python-пакета, мовної моделі Argos, URL LibreTranslate або виконуваного файлу claude. Налаштований сервіс усе одно може згодом перевищити тайм-аут, тому після збоїв під час роботи обробка продовжується тим самим ланцюжком.
Наприклад, я можу перейти на конфігурацію з пріоритетом автономного перекладу, не змінюючи translate_file():
TRANSLATOR_CHAIN = "Argos -> Google (3:20) -> Claude"У цій конфігурації основний пакет отримує Argos. Налаштування переміщуються разом із кожним сервісом: Google (3:20) означає одну спробу й три повторні, причому для кожної повторної спроби тайм-аут збільшується на 20 секунд. Для сервісу без дужок виконується одна спроба без повторення.
Для основного сервісу обробка пакета є першою спробою. Якщо в його конфігурації зазначено Google (2:30), для реплік без прийнятного результату виконуються ще дві спроби через Google із тайм-аутами 60 і 90 секунд, перш ніж перейти до MyMemory. Коли починається зв’язаний ланцюжок, основний сервіс не викликається повторно з початковим тайм-аутом.
Тайм-аут застосовується до кожного фрагмента Google розміром до 20 реплік, кожного фрагмента MyMemory розміром до 5 реплік, кожного HTTP-запиту LibreTranslate й кожного підпроцесу Claude. Обробка всього пакета може тривати довше. Коли час спливає, процеси Google і MyMemory завершуються, а готові фрагменти зберігаються. Автономний бекенд Argos не застосовує цей тайм-аут.
До зв’язаного ланцюжка потрапляють лише репліки без прийнятного результату, тож тайм-аут або порожня відповідь не запускають обробку всього файлу заново. Некоректний крок чи невідомий сервіс зупиняє скрипт під час запуску, замість того щоб непомітно змінити маршрут.
Сам патерн простий. Кожен крок обробляє ті елементи, які може та передає решту до self.next:
class TranslatorStep:
    def __init__(self, name, fn, fallbacks=0, timeout_inc=0, timeout_base=30):
        self.name = name
        self.fn = fn
        self.fallbacks = fallbacks
        self.timeout_inc = timeout_inc
        self.timeout_base = timeout_base
        self.next = None

    def set_next(self, step):
        self.next = step
        return step

    def execute(self, entries, attempts_already_used=0):
        remaining = entries

        total_attempts = self.fallbacks + 1
        for attempt in range(attempts_already_used, total_attempts):
            if not remaining:
                return

            timeout = self.timeout_base + attempt * self.timeout_inc
            result = self.fn(remaining, timeout=timeout)
            remaining = [
                (idx, text) for idx, text in remaining
                if not (
                    result.get(idx)
                    and target_script_ratio(result[idx]) >= MIN_QUALITY
                )
            ]

        if remaining and self.next:
            self.next.execute(remaining)
Ланцюжок будується з конфігурації, а не з жорстко прописаних умов:
steps = [
    TranslatorStep(
        name=step['name'],
        fn=_FN_MAP[step['name']],
        fallbacks=step['fallbacks'],
        timeout_inc=step['timeout_inc'],
    )
    for step in resolved
]

for index in range(len(steps) - 1):
    steps[index].set_next(steps[index + 1])

steps[0].execute(needs_retry, attempts_already_used=1)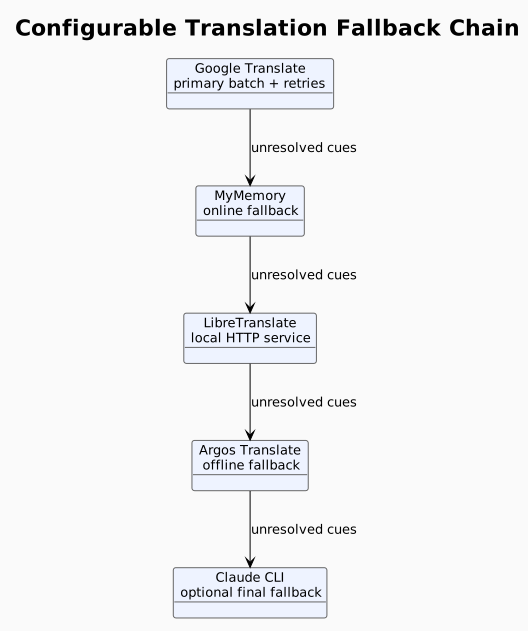
Чому саме такий порядок?
- Google виконує основний прохід, бо в моїх тестах найкраще перекладав діалоги. Скрипт звертається до нього через
deep-translator, чий бекенд Google використовує вебклієнт, а не офіційний платний API. - MyMemory дає другий онлайн-маршрут, коли Google залишає рядок неперекладеним.
- LibreTranslate працює як локальний HTTP-сервер. За окремі запити платити не потрібно, і запит залишається на моїй машині, але якість перекладу цього серіалу була недостатньою, щоб зробити його основним перекладачем.
- Argos Translate працює автономно й не має квоти на запити, але його переклад українською часто був надто буквальним для телевізійних діалогів.
- Claude CLI запускається останнім. Скрипт викликає його як підпроцес лише тоді, коли після інших бекендів залишаються репліки без прийнятного результату.
Ось яку різницю я побачив, коли порівняв автономну модель із Google на справжніх діалогах:
| Оригінал | Argos | |
|---|---|---|
| “I’m sorry” | “Я шкода” | “Вибачте” |
| “Previously on The Fosters” | “Попередньо на піни” | “Раніше у Фостерів” |
Ці приклади пояснюють мій вибір типового порядку; вони не є бенчмарком для різних мов чи жанрів.
Базова перевірка, а не перевірка якості перекладу
Конвеєр обчислює частку літер, що належать до налаштованої писемності цільової мови. Для українських налаштувань це кирилиця:
def target_script_ratio(text):
    alpha = re.findall(ALL_LETTERS_PATTERN, text)
    if not alpha:
        return 1.0
    target_letters = re.findall(TARGET_SCRIPT_PATTERN, text)
    return len(target_letters) / len(alpha)
Результат із часткою менш ніж 70 відсотків передається наступному перекладачу. Якщо прийнятний результат отримано для менш ніж 60 відсотків реплік, які можна перекласти, файл результату відкидається, а повторна спроба відбудеться під час наступного запуску.
За охоплення 60 відсотків або більше скрипт зберігає файл, залишаючи репліки без прийнятного результату оригінальною англійською. Наприклад, файл зі 100 придатними до перекладу репліками може бути прийнято, якщо перекладено 60, а 40 залишилися англійською. Під час наступного запуску пошук файлів пропустить цей .uk.srt і не повторить переклад пропущених реплік усередині нього. Частково перекладені результати мені потрібно перевіряти вручну. Щоб перекласти серію знову, я можу перемістити її результат за межі subtitles_output/ і повторно запустити скрипт, залишивши вихідний файл на місці.
Для вбудованої конфігурації перекладу з англійської на українську це виявляє порожні відповіді, неперекладений англійський текст і деякі некоректні пакети. Перевірка не виявить поганої граматики, втрати контексту, неправильних імен, вигаданого змісту чи неприродної української. Ця частка – механічна перевірка, а не оцінка якості перекладу.
Форматування потребує такої самої обережності. Скрипт зберігає один зовнішній тег у стилі HTML, але вкладені теги можуть загубитися, а багаторядкові репліки перед перекладом перетворюються на один рядок. Якщо оформлення та розриви рядків важливі, перед перекладом їх слід замінити плейсхолдерами, а потім відновити за картою токенів.
Коли рядок проходить механічну перевірку, лишається практичне питання: обробка 106 файлів має переживати переривання.
Продовження роботи й журналювання без початку з нуля
Кожен прийнятий файл результату закінчується на .uk.srt. Пошук файлів пропускає наявний шлях результату, зокрема частково перекладений файл, і планує обробку лише для відсутніх результатів.
subtitles_source/
  Season 1/
    The Fosters S01E01.en.srt

subtitles_output/
  Season 1/
    The Fosters S01E01.uk.srt
Скрипт веде два різні журнали. Log_console.txt відкривається в режимі дописування й дублює все, що виводиться в stdout: сформований ланцюжок, перебіг обробки пакетів, повторні спроби, помилки та підсумок. Я переглядаю його, коли бекенд відмовляє посеред обробки серії.
Log.md – стислий журнал запусків. Скрипт додає на початок рядок із часовою міткою після кожного обробленого файлу й записує ще один рядок, якщо я зупиняю його через Ctrl+C. Кожен рядок містить кількість завершених файлів, спроб завантаження з OpenSubtitles, фраз для кожного перекладача, невдалих серій, залишок локального ліміту OpenSubtitles і оцінку використання Claude, отриману із зовнішнього джерела.
Ось справжня контрольна точка з першого тривалого запуску; я залишив лише доречні тут стовпці:
| 2026-03-29 05:48:59 | 25/88 complete | Google×19,408 | MyMemory×21 | LibreTranslate×44 | Claude×17 |Повний рядок також має машиночитний суфікс [OS:n], що містить лише нові спроби завантаження від попередньої контрольної точки. Під час запуску count_today_os_downloads() підсумовує сьогоднішні позначки, тому кілька запусків користуються спільним локальним денним лімітом і не враховують ту саму спробу двічі.
Кожен SRT спочатку записується в тимчасовий файл поруч із цільовим. Коли всі репліки записано, а буфер скинуто, os.replace() переміщує його в остаточне місце. Це захищає запис від переривання; чи залишить скрипт результат, визначає охоплення прийнятих реплік.
Запуск Claude CLI для решти рядків
Скрипт не звертається безпосередньо до Anthropic API. Для реплік без прийнятного результату він запускає встановлений Claude CLI як підпроцес:
with tempfile.TemporaryDirectory(prefix="subtitle_claude_") as workdir:
    result = subprocess.run(
        [
            "claude", "--print", "--output-format", "text", "--model", CLAUDE_MODEL,
            "--tools", "", "--strict-mcp-config", "--mcp-config", '{"mcpServers":{}}',
            "--disable-slash-commands", "--setting-sources", "", "--no-session-persistence",
        ],
        input=prompt,
        capture_output=True,
        text=True,
        timeout=timeout,
        cwd=workdir,
    )
На кожній спробі в ланцюжку CLI запускається один раз із тайм-аутом цього кроку. CLI працює в порожньому тимчасовому каталозі, а ці прапорці вимикають інструменти, MCP-сервери, слеш-команди й збереження сесії. Текст субтитрів усе одно надходить обраному онлайн-провайдеру; ці налаштування не роблять хмарний переклад приватним чи автономним.
Перед запуском скрипт читає CLAUDE_USAGE_FILE, лише якщо я явно його задав. Зовнішній процес має створити JSON-файл на кшталт {"remaining_percent": 75} і оновлювати його, коли використання змінюється. Значення має бути числом від 0 до 100, а файл – зміненим протягом останніх п’яти хвилин. Скрипт не отримує дані про використання облікового запису й не переглядає історію Claude.
export CLAUDE_USAGE_FILE="./claude-usage.json"
python3 translate_subtitles.py 10 --min-tokens 30
Це зовнішня оцінка, а не перевірка квоти за даними самого сервісу. Якщо файлу немає, він застарів або некоректний, використання вважається невідомим. Тоді скрипт пропускає Claude, якщо я явно не вимкну захист через --min-tokens 0. Окремий процес має атомарно оновлювати файл; фіксоване прикладове значення не допоможе стежити за квотою.
def claude_allowed(min_pct: float) -> bool:
    if _token_pct is None:
        return min_pct == 0
    return _token_pct >= min_pct
Ці прапорці описано в довідці Claude CLI. Використовуйте версію CLI, яка їх підтримує; непідтримуваний виклик завершиться помилкою й залишить відповідні репліки без прийнятного результату.
Довідник налаштувань
Мовна пара та перевірка
У цій статті вихідні субтитри англійською, а результат українською, але це набір налаштувань, а не жорстко заданий маршрут. Пошук в OpenSubtitles, онлайн-перекладачі, пошук пакета Argos, промпт Claude та імена файлів результату використовують такі налаштування:
SOURCE_LANGUAGE_CODE   = "en"
SOURCE_LANGUAGE_NAME   = "English"
SOURCE_LANGUAGE_LOCALE = "en-US"
SOURCE_INPUT_SUFFIX    = "en"

TARGET_LANGUAGE_CODE   = "uk"
TARGET_LANGUAGE_NAME   = "Ukrainian"
TARGET_LANGUAGE_LOCALE = "uk-UA"
TARGET_OUTPUT_SUFFIX   = "uk"
Перевірка мови налаштовується окремо:
ALL_LETTERS_PATTERN               = r'[a-zA-Zа-яА-ЯіІїЇєЄґҐ]'
TARGET_SCRIPT_PATTERN             = r'[а-яА-ЯіІїЇєЄґҐ]'
TARGET_LANGUAGE_MARKERS_PATTERN   = r'[іІїЇєЄґҐ]'
REJECTED_LANGUAGE_MARKERS_PATTERN = r'[ыЫэЭъЪ]'
Щоб адаптувати скрипт, змініть обидві групи. Наприклад, для перекладу з англійської на німецьку задайте чотирьом значенням TARGET_* відповідно de, German, de-DE і de; використайте шаблон латинських літер для ALL_LETTERS_PATTERN і TARGET_SCRIPT_PATTERN; а обидва шаблони маркерів задайте порожніми рядками. Англійська й німецька використовують одну писемність, тому перевірка частки символів більше не зможе виявити неперекладений англійський текст. Конвеєр і далі працюватиме, але саме цей запобіжник перевірятиме структуру, а не мову.
Якщо мова аудіо теж змінюється, передайте її код ISO-639-1 до transcribe-groq.py --language або задайте WHISPER_LANGUAGE для whisper_batch.sh. Потім оновіть усі чотири значення SOURCE_* у translate_subtitles.py відповідно до створених вихідних файлів.
Решта обмежень стосується підтримки бекендів. Для вибраної мовної пари Argos потрібен пакет, а кожен онлайн-сервіс має підтримувати обидва мовні коди.
Налаштування виконання
Типові налаштування виконання розташовані одразу під блоком мов:
OPENSUBTITLES_API_KEY      = os.environ.get("OPENSUBTITLES_API_KEY", "")
OPENSUBTITLES_ACCESS_TOKEN = os.environ.get("OPENSUBTITLES_ACCESS_TOKEN", "")
OPENSUBTITLES_USERNAME     = os.environ.get("OPENSUBTITLES_USERNAME", "")
OPENSUBTITLES_PASSWORD     = os.environ.get("OPENSUBTITLES_PASSWORD", "")
OPENSUBTITLES_APP_NAME     = "SubtitleTranslator/1.0"

BATCH_SIZE          = 80
CLAUDE_MODEL        = "claude-haiku-4-5-20251001"
DELAY_BETWEEN_CALLS = 0.4
MAX_FILES_PER_RUN   = 30
MIN_QUALITY         = 0.70
MAX_SYNC_GAP_MS     = 2000
MAX_SYNC_DRIFT      = 0.10
OS_DAILY_LIMIT      = int(os.environ.get("OPENSUBTITLES_DAILY_LIMIT", "20"))
MIN_TOKENS_PCT = 30| Налаштування | Що воно контролює |
|---|---|
OPENSUBTITLES_API_KEY |
Читає ключ споживача OpenSubtitles зі змінної середовища. Без ключа скрипт пропускає етап OpenSubtitles. |
OPENSUBTITLES_ACCESS_TOKEN |
Приймає наявний Bearer-токен для автентифікованих завантажень. |
OPENSUBTITLES_USERNAME, OPENSUBTITLES_PASSWORD |
Дають скрипту змогу запросити токен сесії під час запуску, якщо токен доступу не було надано. Вони ніколи не виводяться й не записуються в журнал. |
OPENSUBTITLES_APP_NAME |
Надсилає значення User-Agent, потрібне для запитів до OpenSubtitles. |
BATCH_SIZE |
Обмежує кількість унікальних фраз субтитрів, які основний перекладач отримує в одному пакеті. |
CLAUDE_MODEL |
Задає значення, яке передається в claude --model під час запуску останнього резервного сервісу. |
DELAY_BETWEEN_CALLS |
Додає паузу між пакетами перекладу та певними запитами до OpenSubtitles. |
MAX_FILES_PER_RUN |
За замовчуванням обмежує один запуск 30 файлами. Позиційний аргумент CLI перевизначає це значення. |
MIN_QUALITY |
Задає мінімальну прийнятну частку символів цільової писемності для будь-якого перекладача в ланцюжку. Це базова перевірка формату, а не оцінка якості мови. |
MAX_SYNC_GAP_MS |
Відхиляє синхронізований варіант, якщо час початку однієї з перших п’яти реплік відрізняється від англійського файлу більш ніж на 2000 мс. |
MAX_SYNC_DRIFT |
Обмежує коефіцієнт масштабування часу значенням 1.0 ± 0.10, що відсіює, імовірно, несумісні релізи. |
OS_DAILY_LIMIT |
Задає локальний ліміт скрипту на завантаження з OpenSubtitles. OPENSUBTITLES_DAILY_LIMIT перевизначає типове значення. |
MIN_TOKENS_PCT |
Не дає Claude CLI запускатися, якщо зовнішня оцінка залишку використання нижча за заданий відсоток. --min-tokens перевизначає його для одного запуску. |
CLAUDE_USAGE_FILE |
Необов’язкова змінна середовища зі шляхом до JSON-файлу, що містить remaining_percent (0–100) і має бути оновлений зовнішнім процесом не більш ніж п’ять хвилин тому. Якщо використання невідоме, Claude блокується, якщо поріг не дорівнює нулю. |
TRANSLATOR_CHAIN |
Задає порядок бекендів і значення fallbacks:timeout_inc для кожного сервісу. |
LIBRETRANSLATE_URL |
Вмикає локальний крок LibreTranslate, коли змінна середовища містить URL сервера. |
LIBRETRANSLATE_URL також читається зі змінної середовища. Якщо залишити її порожньою, LibreTranslate зникне зі сформованого ланцюжка; якщо вказати URL локального сервера, крок увімкнеться без зміни TRANSLATOR_CHAIN.
Налаштування середовища
Для Python-скриптів потрібен Python 3.10+ на macOS або Linux. Допоміжний скрипт пакетної обробки на власному сервері використовує SSH і очікує, що на сервері є Bash, GNU find/sort та curl.
Для транскрибування через Groq встановіть ffmpeg і переконайтеся, що ffmpeg та ffprobe доступні через PATH. Сам допоміжний Python-скрипт використовує лише стандартну бібліотеку.
export GROQ_API_KEY="your-api-key"
python3 transcribe-groq.py "episode.mkv" --language en
Для локального варіанта потрібен екземпляр whisper-asr-webservice, доступний через SSH. Адреса сервера, користувач, порт, шлях до ключа й вихідна мова беруться зі змінних середовища, показаних раніше; у скрипті, доступному для завантаження, їх не зашито.
Для етапу перекладу створіть віртуальне середовище, замість того щоб змінювати системну інсталяцію Python:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install deep-translator argostranslate
Задайте API-ключ, облікові дані й квоту вашого облікового запису OpenSubtitles. Якщо у вас уже є чинний токен, можете вказати OPENSUBTITLES_ACCESS_TOKEN замість імені користувача та пароля.
export OPENSUBTITLES_API_KEY="your-api-key"
export OPENSUBTITLES_USERNAME="your-username"
export OPENSUBTITLES_PASSWORD="your-password"
export OPENSUBTITLES_DAILY_LIMIT="20"
Необов’язкові локальні сервіси:
# Argos package index and the default English-to-Ukrainian model
argospm update
argospm install translate-en_uk

# LibreTranslate
docker run --rm -p 127.0.0.1:6455:5000 libretranslate/libretranslate
export LIBRETRANSLATE_URL="http://127.0.0.1:6455"
Поточні деталі встановлення краще шукати в репозиторії Argos Translate і посібнику зі встановлення LibreTranslate.
Потім покладіть англійські файли субтитрів у subtitles_source/ і запустіть:
python3 translate_subtitles.py       # up to 30 files
python3 translate_subtitles.py 10    # up to 10 files
python3 translate_subtitles.py --debug-tokens
Завантажте скрипти для двоетапного процесу:
- Перекласти й синхронізувати пакет із можливістю продовження
- Транскрибувати один аудіо- чи відеофайл через Groq Whisper
- Транскрибувати віддалений каталог медіафайлів через власний сервер Whisper
Результати першого запуску
106 серій у заголовку – це розмір моєї колекції. Перший тривалий запуск перекладу охоплював 88 файлів серій, що чекали на обробку, і до показаної вище контрольної точки рано-вранці зберіг 25 результатів. Тут зафіксовано саме цей перебіг роботи, а не остаточну кількість завершених серій із усіх 106. Уривок не дає змоги визначити стан решти 18 серій.
У цій контрольній точці «завершено» означає, що скрипт прийняв і зберіг результат. За порога 60 відсотків деякі прийняті файли все ще можуть містити англійські репліки. Наступні запуски також їх пропускають.
OpenSubtitles не дав жодного завершеного файлу під час того запуску. Пошук повертав варіанти, але запити /download отримували HTTP 403. Я підозрював початкову схему автентифікації, хоча сам цей статус не доводить причини. Версія для завантаження використовує явно автентифікований шлях завантаження: входить за обліковими даними зі змінних середовища або приймає токен доступу, додає Authorization: Bearer ... і пропускає завантаження, коли автентифікація недоступна.
Більшість реплік не доходила до Claude CLI, бо їх обробляв один із попередніх бекендів. Фактичне співвідношення змінювалося від серії до серії залежно від того, які субтитри вже існували й які сервіси були доступні.
Скрипт показує охоплення прийнятих реплік, а не мовну якість. Файл зі 100-відсотковим охопленням усе одно може містити незграбні формулювання, тому цей відсоток слід читати як «кожна репліка отримала прийнятий результат», а не «кожен переклад правильний».
Поточні обмеження
Перш ніж вважати цей скрипт універсальним інструментом для субтитрів, я б змінив ще сім речей:
- Перевіряв би імена та місця розрізання на фрагменти у вихідних файлах, створених Whisper, перед перекладом.
- Зіставляв би результати OpenSubtitles за ідентифікаторами IMDb або TMDB, а не лише за текстом назви.
- Визначав би кодування субтитрів, замість того щоб декодувати кожне завантаження як UTF-8 із заміною некоректних символів.
- Зберігав би вкладені теги й розриви рядків за допомогою плейсхолдерів.
- Замінив би перевірку таймінгу за індексами зіставленням тексту реплік або звукових орієнтирів.
- Замінив би перевірку частки символів визначенням мови для випадків, коли вихідна й цільова мови мають спільний алфавіт.
- Додав би інтеграційні тестові дані для меж фрагментів транскрибування, постійного зміщення, рівномірного розходження таймінгу й навмисно несумісного релізу субтитрів.
Наступна складна проблема – довести правильність субтитрів, не переглядаючи всі 45 хвилин. Додавання шостого перекладача її не розв’яже.